Automatizujeme tvorbu obsahu pro Arval. Content Brain zpracovává stovky zdrojů a připraví článek za méně než 3 minuty
Umělá inteligence mění způsob, jakým firmy vytvářejí obsah i jakým zákazníci informace vyhledávají. Vedle Googlu stále častěji využívají nástroje jako ChatGPT nebo Gemini, které jim pomáhají porovnávat produkty, hledat řešení konkrétních problémů a rozhodovat se o nákupu. Pro firmy to znamená novou příležitost, ale také závazek. Pokud o svých produktech a službách neposkytují dostatek kvalitních informací, mohou ztrácet viditelnost v prostředí, kde jejich zákazníci hledají odpovědi.
Samotná produkce textů už přitom není hlavní překážkou. S pomocí jazykových modelů dnes dokáže velké množství obsahu vytvořit téměř každý. Rozdíl mezi průměrným a skutečně užitečným článkem ale často spočívá v informacích, které nejsou běžně dostupné na internetu. V interním know-how, produktových podkladech, zkušenostech zaměstnanců nebo datech, která firma dosud nedokázala systematicky využívat.
Právě s tímto problémem pracujeme v TRITON IT. Vyvíjíme vlastní automatizační workflow Content Brain, které propojuje firemní znalosti, jazykové modely a kontrolní mechanismy do jednoho procesu. Jedním z projektů, na kterých tento přístup rozvíjíme, je spolupráce se společností Arval, pro kterou zajišťujeme kompletní digitální marketing.
Arval měl informace. Potřebovali jsme je zpřístupnit
Jedním z dlouhodobých cílů naší spolupráce s Arvalem, významným poskytovatelem operativního leasingu, je posilování povědomí o značce. K tomu nestačí pouze reklamní kampaně. Důležitou roli hraje také dlouhodobě budovaný odborný obsah, který odpovídá na otázky potenciálních zákazníků, vysvětluje služby a pomáhá jim orientovat se v nabídce.
Arval přitom rozhodně nezačínal od nuly. K dispozici měl velké množství informací na svém webu i ve. Patřily mezi ně produktové podklady, brožury, příručky, statistiky, informace o vozidlech a další dokumenty vznikající v různých částech společnosti. Některé byly veřejně dostupné, jiné zůstávaly v interních složkách a k běžné obsahové tvorbě se prakticky nedostávaly. Naším úkolem bylo tyto zdroje zpracovat tak, aby se daly systematicky využívat při přípravě nových článků.
To je důležitý rozdíl oproti běžnému použití generativní AI. Pokud modelu zadáme pouze téma a název značky, může vytvořit čtivý text, ale nemusí znát aktuální nabídku vozů, konkrétní podmínky služeb ani specifika komunikace dané společnosti. U odborného obsahu navíc hrozí, že obecně znějící tvrzení zastoupí skutečné informace, které by měly být základem článku. Proto jsme u Arvalu nejprve řešili data a až následně samotnou produkci.
Stovky souborů v jedné znalostní bázi
Základem Content Brainu je znalostní báze, kterou připravujeme samostatně pro každého klienta. Nejde o pouhé úložiště dokumentů. Je to strukturovaný zdroj informací, ze kterého workflow čerpá při přípravě jednotlivých výstupů. U Arvalu jsme do ní postupně zapojili stovky různých souborů a informačních zdrojů. Vedle veřejného obsahu webu a produktových materiálů jsme zpracovali také dokumenty, které byly dosud využívány především interně. Součástí systému se staly rovněž informace o aktuální nabídce vozidel, novinky automobilek a relevantní zmínky o Arvalu z internetových zdrojů.
Tím se otevřela možnost vytvářet obsah, který propojuje několik typů informací. Článek o konkrétním vozidle nemusí vycházet pouze z obecné specifikace modelu. Může pracovat také s aktuální nabídkou, kontextem operativního leasingu a dalšími podklady, které pomáhají vysvětlit, pro koho může být daný vůz vhodný.
Jedním z nejcennějších, ale zároveň nejnáročnějších zdrojů bylo Arval Mobility Observatory (AMO), pravidelně vydávaná publikace, která přináší rozsáhlé informace o vývoji mobility. Obsahuje například statistiky týkající se operativního leasingu, elektromobility a vývoje automobilového trhu v České republice.
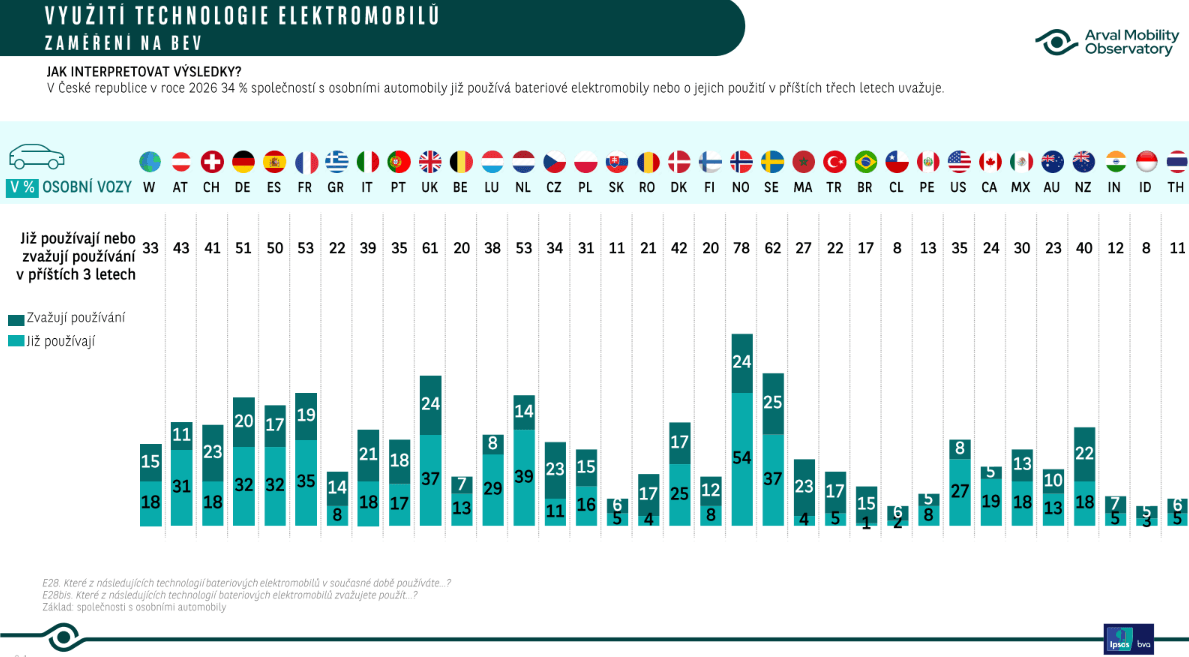
Takové materiály mají vysokou informační hodnotu, ale jejich využití v automatizovaném systému není samozřejmé. PDF dokument může obsahovat stovky grafů, tabulek a vizualizací, jejichž význam se při běžném převodu do prostého textu částečně nebo úplně ztratí. Samotné hodnoty bez správných popisků, jednotek, časového období a kontextu nemusí dávat smysl. Proto jsme museli data nejprve převést do strojově čitelné podoby. U grafů a tabulek bylo potřeba zachovat vztahy mezi jednotlivými údaji, jejich význam a souvislosti. Teprve takto připravené informace lze spolehlivěji využívat při tvorbě článků.
Právě v této fázi vzniká část hodnoty, kterou nelze nahradit pouhým připojením jazykového modelu k několika dokumentům. Model může pracovat jen s informacemi, které se mu podaří získat a správně interpretovat. Kvalita výsledného článku proto závisí také na kvalitě přípravy zdrojových dat.
Jak Content Brain hledá správné informace
Technickým základem vyhledávání ve znalostní bázi je princip RAG, tedy Retrieval-Augmented Generation. Jedná se o způsob práce s AI, při kterém jazykový model před vytvořením výstupu dostane relevantní informace z externího zdroje, místo aby se spoléhal pouze na své obecné znalosti.
V našem řešení se dokumenty zpracovávají prostřednictvím nástrojů pro práci se znalostní bází a ukládají do vektorové databáze. Jejich části se převádějí do takzvaných embeddingů, číselných reprezentací významu textu. Díky tomu může systém vyhledávat podle významové podobnosti, nikoli jen podle přesné shody slov. Pokud například zadáme téma zaměřené na výhody elektromobilu pro firemní flotilu, workflow může najít související informace v podkladech o vozidlech, datech o elektromobilitě i materiálech věnovaných mobilitním potřebám firem. Nemusí přitom hledat pouze dokumenty, které obsahují přesně stejnou formulaci jako zadání.
Znalostní báze v tomto procesu funguje jako hlavní zdroj podkladů pro tvorbu obsahu. Workflow z ní získává informace pro konkrétní téma a předává je dalším částem procesu. Díky tomu nemusíme při každém novém článku ručně připravovat rozsáhlé zadání a znovu vysvětlovat základní fakta o společnosti, jejích produktech a službách.
Současně ale platí, že ani rozsáhlá znalostní báze sama o sobě nezaručuje správnost každého výstupu. Rozhoduje také aktuálnost zdrojů, kvalita jejich zpracování a způsob, jakým systém s nalezenými informacemi pracuje. Proto je další důležitou součástí Content Brainu kontrola kvality.
Quality control: nestačí, aby článek dobře zněl
Po získání relevantních podkladů přichází na řadu tvorba článku. Content Brain přitom nefunguje jako jediný univerzální chatbot, kterému předáme téma a následně bez dalšího schvalování publikujeme jeho odpověď. Jde o automatizované workflow, v němž jednotlivé části plní konkrétní úkoly.
Pro Arval jsme definovali pravidla, která odpovídají jeho produktům, cílovým skupinám i interním požadavkům na komunikaci. Patří mezi ně struktura článků, pravidla pro nadpisy a odstavce, tone of voice, zakázaná slova a formulace i požadavky na čitelnost a srozumitelnost.
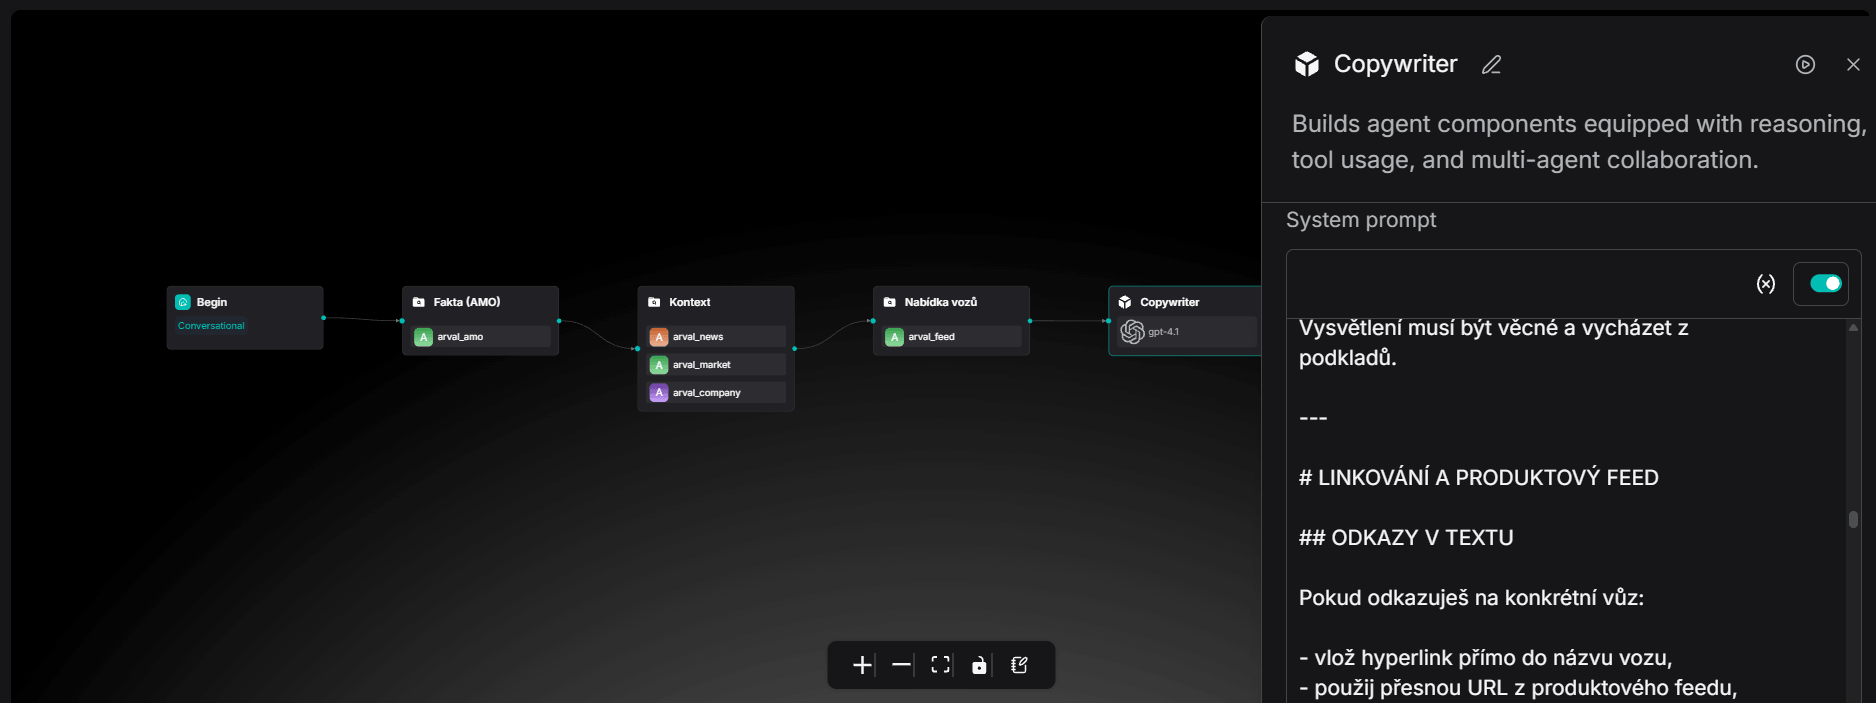
Součástí zadání jsou také pravidla pro SEO a GEO, tedy optimalizaci obsahu pro klasické vyhledávače a jeho dohledatelnost v prostředí generativní AI. Text musí mít jasnou strukturu, srozumitelně vysvětlovat jednotlivé pojmy a poskytovat dostatek kontextu, aby jeho obsahu rozuměli lidé i systémy, které informace zpracovávají automatizovaně.
Po vytvoření první verze následuje kontrolní fáze. Specializované kontrolní mechanismy prověřují, zda článek odpovídá dostupným podkladům, neobsahuje nepodložená tvrzení a respektuje definovaná pravidla. Další kontrola se zaměřuje na strukturu, styl a splnění požadavků na výsledný text. Pokud se objeví nedostatky, workflow může navrhnout úpravy a znovu výstup vyhodnotit.
Důležité je také rozlišovat mezi automatickou kontrolou a odborným schválením. Quality control dokáže zachytit řadu problémů ještě před předáním článku, ale nenahrazuje znalost konkrétního produktu ani odpovědnost člověka za finální obsah. U klientů je proto nezbytné respektovat také interní schvalovací procesy. Článek je nahrán do redakčního systému, kde probíhá finální schválení klienta.
Oponentura od manažerů Arvalu se stala součástí vývoje
Po nastavení první verze workflow jsme připravili úvodní sadu článků a předali ji Arvalu k oponentuře. Jednotlivé texty se dostaly až k vedoucím příslušných divizí, kteří mohli posoudit nejen faktickou správnost, ale také to, zda články odpovídají způsobu, jakým společnost své služby skutečně prezentuje.
Tato fáze byla důležitá z několika důvodů. Interní specialisté znají souvislosti, které nemusí být zachycené v běžně dostupných materiálech. Mohou upozornit na nevhodnou formulaci, důležitou výjimku, specifickou terminologii nebo detail, který by v kontextu Arvalu mohl vyvolat nesprávné očekávání zákazníka.
Získanou zpětnou vazbu jsme následně zapracovali do systému. Podle její povahy upravujeme pravidla pro tvorbu a kontrolu výstupů nebo doplňujeme znalostní bázi o nové informace. Nejde tedy o to, že bychom každou připomínku jednoduše připojili k jednomu článku. Cílem je využít ji ke zlepšení dalších výstupů.
Tím vzniká průběžně rozvíjený proces. Systém vychází z dostupných podkladů, vytváří návrhy, prochází kontrolou a získává další kontext od lidí, kteří danému oboru rozumějí. Automatizace tak není jednorázovým nasazením nástroje, ale postupným přizpůsobováním workflow konkrétnímu klientovi.
Od článku k blogu, který má smysl pro vyhledávání
Samotná schopnost rychle vytvářet články by ale nestačila, pokud by výsledný obsah vycházel na blogu, který není připravený na jeho systematické publikování. Ještě před zahájením nové obsahové produkce jsme proto analyzovali stávající blog Arvalu. Cílem bylo identifikovat úpravy, které je potřeba provést, aby nové články nebyly pouze dalšími stránkami na webu, ale součástí srozumitelné informační struktury.
Na základě analýzy jsme klientovi předložili návrh změn, které se týkaly organizace a prezentace obsahu. Vznikl například návrh souhrnného přehledu článků, systému štítků a propojování článků s relevantními vozy z aktuální nabídky. Právě poslední bod je pro Arval podstatný. Článek věnovaný konkrétnímu typu vozidla může čtenáři pomoci pochopit jeho vlastnosti a vhodnost pro určité použití. Pokud se zároveň dokáže snadno dostat k odpovídajícím vozům v nabídce operativního leasingu, propojuje informační obsah s další fází rozhodování zákazníka.
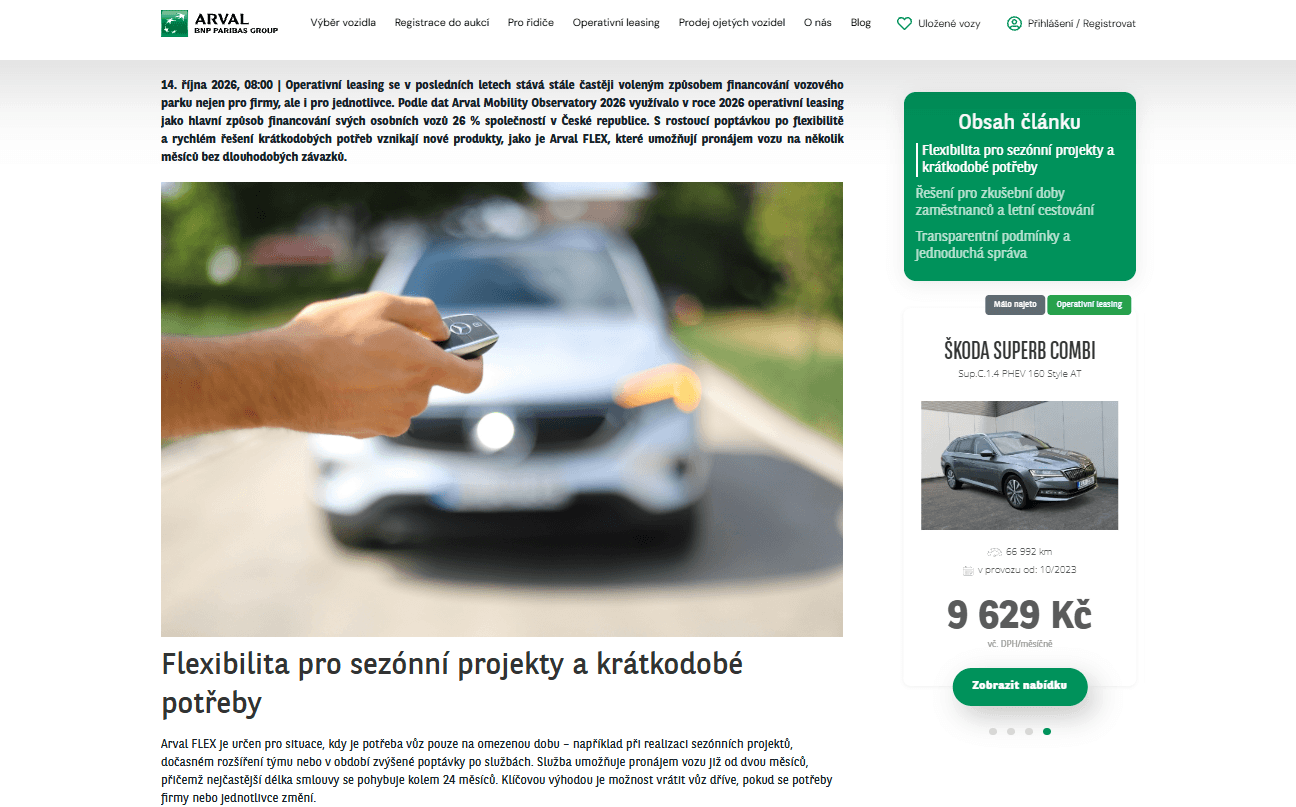
Struktura blogu má význam také pro vyhledávače a jazykové modely. Přehledné kategorie, logické interní odkazy a jasné vztahy mezi jednotlivými stránkami usnadňují orientaci v obsahu. Samotná technická úprava samozřejmě nezaručuje lepší pozice ani citování v odpovědích AI, vytváří však podmínky, aby se kvalitní obsah mohl lépe uplatnit. Proto jsme nejprve řešili podobu blogu a až následně začali ve větším měřítku publikovat nové články.
Téměř 40 nových článků za dva měsíce. Návrh na stole za méně než tři minuty
Výsledkem je workflow přizpůsobené specifickým potřebám Arvalu, jeho komunikačním pravidlům i interním procesům. Od zadání tématu přes vyhledání relevantních podkladů až po vytvoření a prvotní kontrolu článku dnes systém zvládne připravit výstup a předat jej klientovi za méně než tři minuty. Tento čas je důležité chápat správně. Jde o automatizované zpracování článku do podoby připravené k předání, nikoli o kompletní marketingový proces včetně odborné oponentury, schválení a publikace. Tyto kroky mají vlastní význam a jejich délka závisí také na požadavcích klienta.
Content Brain nám nicméně umožňuje výrazně ušetřit čas, který bychom jinak věnovali opakovanému dohledávání informací, přípravě podkladů a sestavování prvních verzí textů. Zároveň můžeme při tvorbě využívat informace, které by se do běžného zadání jen obtížně vešly. Na blog Arvalu jsme tímto způsobem připravili během prvních dvou měsíců od spuštění Content Brainu již téměř 40 nových článků. Nejde přitom o produkci textů bez vazby na obsahovou strategii. Každý výstup vzniká na základě předem definované mindmapy témat, na základě dostupných zdrojů a pravidel, která jsme s klientem nastavili.
Content Brain se dál učí z nových zdrojů
Vývoj tím nekončí. Průběžně sbíráme zpětnou vazbu od jednotlivých manažerů Arvalu, upravujeme kontrolní pravidla a rozšiřujeme znalostní bázi o další zdroje, které mohou zvýšit informační hodnotu budoucích článků. Postupně do ní přidáváme například přepisy podcastů a rozhovory, které Arval poskytl externím médiím. Takové materiály mohou obsahovat vysvětlení odborných témat, zkušenosti a souvislosti, které v produktových dokumentech nebo na webu nenajdeme.
 Spolupráce s TRITON IT nám ukázala, že umělá inteligence může mít v obsahovém marketingu skutečný praktický přínos. Oceňuji především to, že se podařilo propojit naše PR výstupy, produktové informace a další zdroje do jednoho funkčního systému, který nám pomáhá připravovat odborný obsah rychleji a efektivněji. Důležité pro nás je také to, že řešení respektuje specifika naší komunikace a umožňuje nám průběžně zvyšovat kvalitu výstupů.

Právě v tom vidíme jednu z nejdůležitějších vlastností celého řešení. Firemní know-how není omezené na to, co se aktuálně nachází na webu. Často je rozptýlené napříč odděleními, dokumenty, rozhovory a zkušenostmi konkrétních lidí. Pokud se podaří tyto informace zpracovat a zpřístupnit, mohou se stát podkladem pro dlouhodobě konzistentní obsahovou komunikaci.
U Arvalu tak postupně rozvíjíme nejen automatizaci samotného psaní, ale celý proces, který propojuje firemní know-how, tvorbu obsahu, kontrolu kvality a jeho prezentaci na webu. Pro nás je to další příklad toho, že smysluplná automatizace nezačíná výběrem jazykového modelu. Začíná pochopením toho, jaké informace má firma k dispozici, co z nich potřebuje předat zákazníkům a jak nastavit proces, který to dokáže dělat opakovaně a pod kontrolou.
Chcete automatizovat tvorbu obsahu?
Související články
 Případová studie
Hotelové informační systémy bývají velmi dobré v tom, pro co byly vytvořené. Spravují rezervace, obsazenost pokojů, pobyty hostů, fakturaci...
 O nás
Jak vypadá využití umělé inteligence při tvorbě videí? Co jsou MCP servery a jak pomáhají vývojářům? A co kdyby šlo pomocí běžného textového...
Případová studie
ACOND patří mezi přední české výrobce tepelných čerpadel a na trhu působí od roku 1998. Vývoj, testování a výroba jeho tepelných čerpadel probíhá...